MiniMax M3.1 Flash 把输入价砍到每百万 token 0.15 美元,官方称 agent 成本降 70%、速度快三倍。但单价降不等于账单降——聊天是一次问答,agent 是几十次调用的循环。铠盒AIBOX 的答案是把调度权放回自己的底座。
铠盒AIBOX看趋势:MiniMax M3.1 Flash 单价砍七成,账单反而可能涨
铠盒AIBOX 看这次发布:MiniMax 在 10 月 19 日推出 M3.1 Flash,输入每百万 token 0.15 美元,输出 0.60,缓存 0.015。官方说 agent 任务总成本比上一代低 70%,速度接近三倍。
上一代 M3 是 0.30 和 1.20,这次等于腰斩再腰斩。规格也对得起这个价格:100 万 token 上下文,文本、图片、视频都能输入,思考深度五档可调。
但有个现象,换上去的人慢慢会碰到:账单没降。
原因其实很简单,只是不太直观。
聊天的成本是线性的。你问一句,它答一句,用了多少 token 一目了然。Agent 的成本是循环的。它读文件、调工具、看结果、发现自己错了、重来、跑测试、又报错、再改。一个把报表整理成看板的活,背后三十次、五十次调用很正常。
所以单价降 70%,如果调用量涨三倍,总账是 0.9 倍。反而高了。
这不是猜测。MiniMax 自己说,他们拿来匿名验证的那个 Space Bunny,两周处理了 200 万亿 token。便宜的价格会直接变成更高的调用密度。
那省钱的动作到底在哪?
第一是时间。不急的活别白天跑,攒到闲时批量执行。云端算力和电价都有峰谷差。
第二是深度。这个模型的思考关不掉,只能调档,默认还是最费的 max。日常琐事用低档就够,但没人会主动提醒你改。
第三是缓存。同一份资料再读一遍,命中缓存只要十分之一的价格。前提是设备记得读过。
第四是断点续跑。任务失败了,从头来还是接着来,差的不是一点。
这四件事,模型一件都做不了。它们都在模型外面。
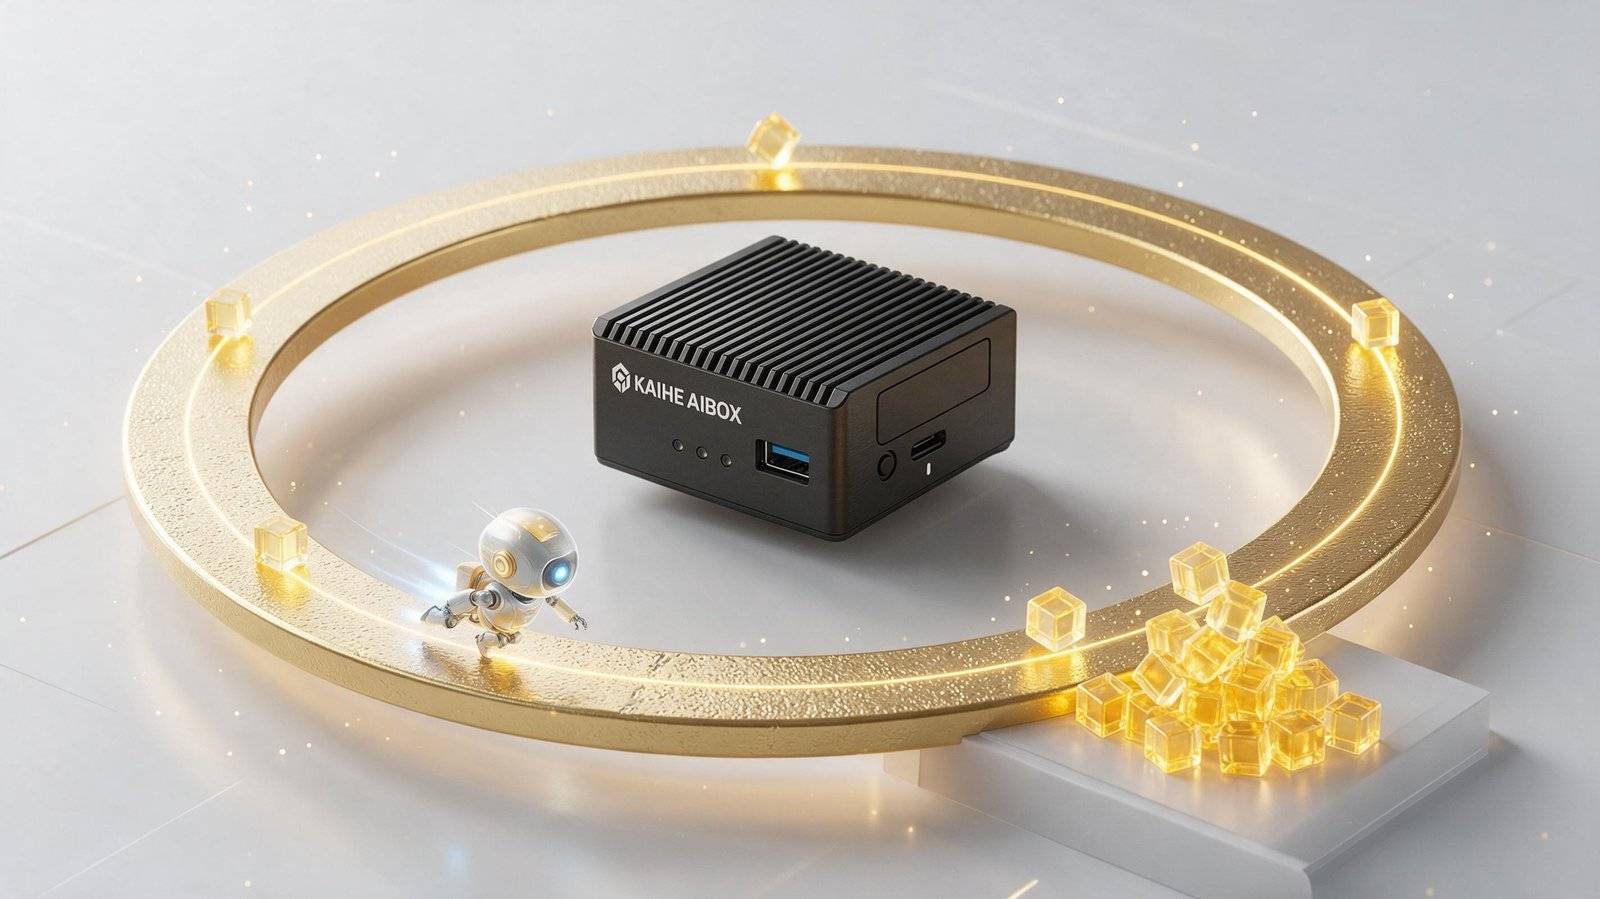
铠盒AIBOX 是一台专用的智能体计算机,按智能体运行做专门优化。它干的正是这一层:白天设好任务,夜里自己跑;按活配思考深度;结果缓存复用;7×24 独立运行不占电脑;一次买断,没有软件订阅费。模型可以随时换,底座是你自己的。
要说清楚一点,这次成绩全是厂商自己测的:DeepSWE v1.1 是 73.7%,OSWorld V2 是 61.7,CyberGym 是 82%。今年已经有过教训,Kimi K2 公布约 50%,独立复测只有 29.4%。标称和复现之间隔着一层。
说到底,模型越来越便宜是确定的事。今年一整年,DeepSeek、GLM、LongCat、MiniMax 都在打价格战。当人人都能用上便宜的模型,便宜就不算优势了。真正能拉开差距的,是谁能把便宜用满。
评论 (0)
登录后参与评论